Schema y datos estructurados para GEO: la guía práctica para que ChatGPT y Perplexity citen tu web
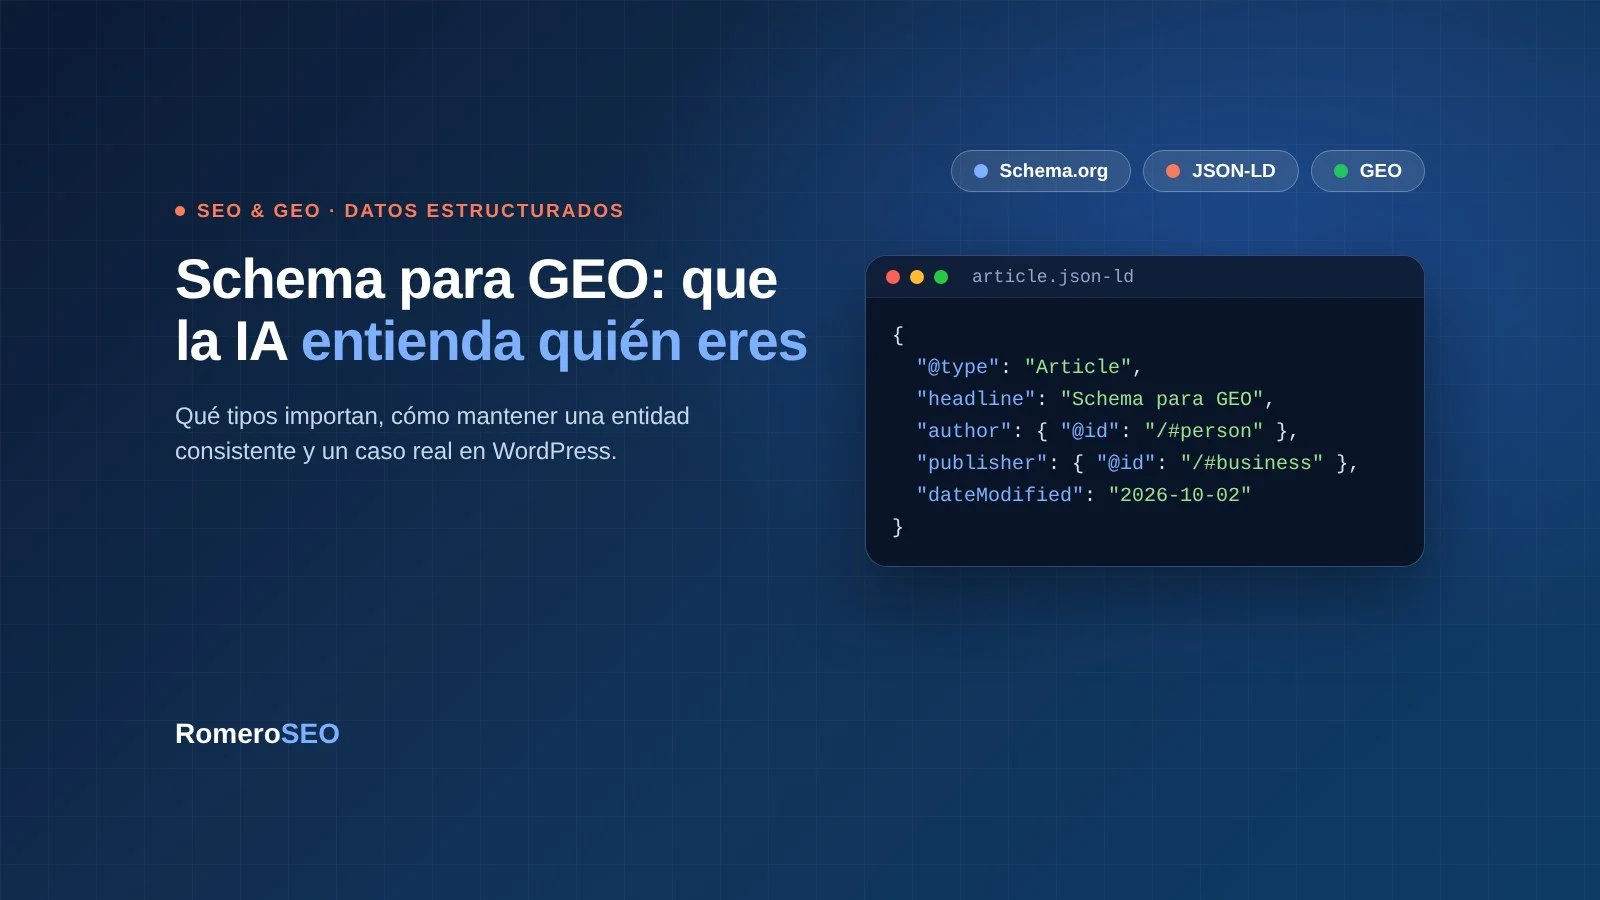
SCHEMA.ORGJSON-LDGEO
Cómo estructurar tu contenido para que una IA lo entienda, no solo Google
JSON-LD, consistencia de entidad y un caso real de implementación en WordPress.
Llevo cinco artículos explicando qué es el GEO, por qué el SEO de toda la vida ya no basta y qué diferencia a una marca citada por ChatGPT de otra que no lo es. Lo que no he explicado todavía es la parte que hace falta para llevarlo a código: cómo le dices a un modelo de lenguaje, de forma explícita y verificable, qué es tu contenido, quién lo firma y qué relación tiene con el resto de tu sitio.
Eso es exactamente lo que hace el schema, o datos estructurados en formato JSON-LD: un bloque de código que no cambia nada de lo que ve una persona en tu página, pero cambia por completo lo que puede "entender" de ella un motor de búsqueda o un modelo de IA generativa.
El schema no es un truco de SEO técnico para conseguir una estrellita en Google. Para GEO es la forma más explícita de declarar entidad, autoría y estructura. Pero no voy a venderte humo: que ayude a que ChatGPT o Perplexity te citen no lo ha confirmado ninguno de los dos. Te marco qué está documentado y qué es hipótesis.
En este artículo no voy a repetir qué es el GEO ni por qué importa — eso ya está en qué es el GEO y el marco de las 4E. Esta es la guía de implementación: qué tipos de schema importan de verdad, cómo declarar una entidad consistente en todo tu sitio, un ejemplo real de este mismo blog, y qué hacer si tu WordPress, como el mío, no tiene un editor de schema por entrada.
Actualizado el 2 de octubre de 2026: Google retiró los resultados enriquecidos de FAQ y he corregido las partes del artículo que dependían de ellos.
Puntos clave
- El schema no es solo para rich snippets: es la forma más explícita de declarar qué es tu contenido, quién lo firma y qué entidad hay detrás. Que OpenAI o Perplexity lo usen para citar no está confirmado; Google dice que no hay schema especial para AI Overviews.
- Para contenido editorial y de servicios, los tipos que más pesan son Article, FAQPage, BreadcrumbList, Person (autor) y Organization/ProfessionalService — HowTo solo cuando el contenido es realmente un proceso paso a paso.
- La consistencia de entidad (mismo nombre, misma URL de autor, mismo publisher en todo el sitio) pesa tanto como el schema en sí: un dato correcto pero inconsistente confunde igual que no tenerlo.
- Si tu plugin SEO no tiene editor de schema por entrada — caso real de este sitio con SEOPress Lite —, WPCode con lógica condicional por URL es una alternativa gratuita y perfectamente funcional.
Ve directo a lo que buscas:
- Por qué el schema importa para GEO (no solo para rich snippets)
- Los tipos de schema que más importan para contenido editorial y de servicios
- Consistencia de entidad: mismo nombre, misma URL de autor, mismo publisher
- Un ejemplo real: así se implementó en el post de clínicas dentales
- Si tu WordPress no tiene schema nativo por entrada: la alternativa con WPCode
- Errores habituales
- Checklist final
Por qué el schema importa para GEO (no solo para rich snippets)
Cuando alguien piensa en schema, piensa en Google: estrellas de reseña, el precio bajo un producto, la pregunta desplegable de un FAQ en los resultados de búsqueda. Eso son rich snippets, y son un efecto visible del schema, no su función principal.
Un motor generativo no lee tu página como un buscador tradicional. No la indexa para devolver diez enlaces azules; extrae fragmentos, los relaciona con una pregunta y decide si merece la pena citarte dentro de una respuesta. Para eso necesita resolver, en segundos, tres preguntas que el HTML normal responde de forma ambigua: qué tipo de contenido es esto, quién lo ha escrito y qué entidad — persona o negocio — respalda esa afirmación.
El texto visible responde a esas preguntas de forma implícita, y una IA tiene que inferirlas. El schema las responde de forma explícita, en un formato que la máquina no tiene que interpretar. Esa diferencia, aplicada a todo un sitio, es la que separa una web que un modelo puede verificar rápido de una que tiene que reconstruir a base de suposiciones.
Esto conecta directamente con el pilar de Entidad del marco de las 4E: el schema es, literalmente, el mecanismo técnico con el que declaras esa entidad en código.
Conviene separar lo que sabemos de lo que suponemos. Google lo dice sin rodeos: no hace falta ningún schema especial para aparecer en AI Overviews ni en AI Mode. Microsoft, en cambio, ha afirmado que el schema ayuda a Copilot a entender el contenido. De OpenAI y Perplexity no he encontrado documentación oficial que confirme que usen JSON-LD para decidir qué citan. Mi lectura: el schema no te da citas por sí solo, pero reduce ambigüedad, es barato y es la base de cualquier estrategia de entidad. Trátalo como higiene técnica, no como palanca.
Los tipos de schema que más importan para contenido editorial y de servicios
No necesitas cubrir todo schema.org. Para un blog o una web de servicios, hay un puñado de tipos que hacen la mayor parte del trabajo:
| Tipo de schema | Qué declara | Por qué importa para GEO |
|---|---|---|
| Article | Titular, fecha, autor e imagen de un contenido editorial | Le dice a la IA que esto es una pieza editorial verificable, no una landing genérica |
| FAQPage | Preguntas y respuestas explícitas, en pares | Ya no da rich result en Google, pero deja cada respuesta aislada y fácil de extraer |
| BreadcrumbList | La jerarquía de la página dentro del sitio | Da contexto de categoría y refuerza de qué trata el sitio en su conjunto |
| Person | Nombre, credenciales y URL del autor | Es la señal de autoría verificable, clave donde la confianza importa |
| Organization / ProfessionalService | Nombre, URL y naturaleza del negocio que publica | Declara quién es el publisher, y debe repetirse igual en cada página |
| HowTo | Pasos numerados de un proceso | Google ya no lo muestra; solo tiene sentido si el contenido es de verdad una secuencia de pasos |
Ojo con el FAQPage y el HowTo. Google retiró los resultados enriquecidos de FAQ en 2026 y ya no vas a ver el desplegable en la SERP; el HowTo dejó de mostrarse en 2023. Sigo usando FAQPage porque deja preguntas y respuestas aisladas y fáciles de extraer, pero como señal de entendimiento, no como truco para ganar CTR.
Si prefieres que alguien revise esto por ti en vez de aprender JSON-LD línea a línea, es justo el tipo de trabajo que hago dentro de SEO para IA (GEO).
Consistencia de entidad: mismo nombre, misma URL de autor, mismo publisher
Declarar bien un tipo de schema en una página y declararlo distinto en la siguiente es, para una IA, casi tan malo como no declararlo. Un modelo que ve tres versiones distintas del nombre de tu negocio, dos URLs de autor diferentes para la misma persona, o un publisher que cambia de una entrada a otra, no tiene forma sencilla de confirmar que todas esas páginas pertenecen a la misma entidad — y sin esa confirmación, no arriesga a citarte con autoridad.
La regla práctica es simple: el campo author.url tiene que apuntar siempre a la misma página, con el mismo author.name en cada artículo; el publisher.name y el publisher.url tienen que ser idénticos, carácter a carácter, en cada schema Article que publiques; y esa misma identidad debe coincidir con lo que dice tu pie de página, tu ficha de Google Business y tus redes.
Esto es exactamente el pilar de Entidad de las 4E: no basta con tener los datos correctos una vez, hace falta que sean el mismo dato repetido sin variación en cada punto de contacto.
Un ejemplo real: así se implementó en el post de clínicas dentales
El caso más verificable que tengo de esto ya en marcha es el propio blog: GEO para clínicas dentales tiene implementado Article, FAQPage y BreadcrumbList.
La implementación no depende de ningún plugin de pago: es un fragmento HTML en WPCode con los tres bloques JSON-LD uno detrás de otro, insertado automáticamente "después del contenido" de esa entrada, con una condición de URL para que solo se cargue ahí. Simplificado, el bloque Article tiene esta forma (author y publisher apuntan por @id a entidades declaradas una sola vez):
{
  "@context": "https://schema.org",
  "@type": "Article",
  "@id": "https://tusitio.com/tu-articulo/#article",
  "headline": "Título del artículo",
  "image": "https://tusitio.com/wp-content/uploads/imagen-destacada.jpg",
  "datePublished": "2026-08-20T18:47:42+00:00",
  "dateModified": "2026-10-02T12:00:00+00:00",
  "author": { "@id": "https://tusitio.com/#person" },
  "publisher": { "@id": "https://tusitio.com/#business" },
  "mainEntityOfPage": "https://tusitio.com/tu-articulo/"
}
A eso se le añade un bloque FAQPage con las preguntas del propio artículo — palabra por palabra igual que en el texto visible — y un BreadcrumbList con la jerarquía Inicio → categoría → artículo. Tres bloques de script independientes, dentro del mismo fragmento de WPCode.
Fíjate en un detalle del ejemplo: author y publisher no repiten los datos, apuntan por @id a una única Person y a un único ProfessionalService declarados una sola vez en el sitio. Es la forma más limpia de garantizar la consistencia: la identidad vive en un solo sitio y todo lo demás la referencia.
Este artículo lleva hoy Article y BreadcrumbList, enlazados por @id a la misma Person y al mismo ProfessionalService del resto del sitio. FAQPage todavía no lo tiene: solo lo implementé en el de clínicas dentales. Te lo cuento porque el checklist de abajo es el estándar que me aplico, y aquí aún no lo cumplo del todo.
Si tu WordPress no tiene schema nativo por entrada: la alternativa con WPCode
Si usas un plugin SEO con editor de schema por entrada (Rank Math, Yoast, SEOPress Pro), esto se hace desde la propia pantalla de la entrada, sin tocar código. El caso real de este sitio es el contrario: uso SEOPress Lite, que no incluye editor de schema por entrada. La alternativa gratuita con la que trabajo es WPCode:
- Instala WPCode (versión Lite, gratuita) y crea un fragmento de código nuevo.
- Elige "Fragmento de HTML" como tipo, y pega tus bloques de script JSON-LD.
- En "Método de inserción" elige "Insertar automáticamente" y, como ubicación, "Insertar después del contenido".
- Activa la "Lógica condicional inteligente" y añade la condición: URL de la página → Contiene → /el-slug-de-tu-artículo/.
- Guarda y activa el fragmento. Repite un fragmento por cada artículo al que quieras añadir schema.
Es un método manual y no escala a cientos de entradas, pero para las piezas clave de tu cluster de contenido es gratuito, fiable y no depende de ningún plan de pago.
Errores habituales
- Schema inconsistente con el contenido visible: declarar preguntas en el FAQPage que no aparecen en el texto del artículo, o un autor distinto al que firma arriba.
- JSON-LD roto o no validado: una coma de más, comillas sin escapar o un campo mal cerrado invalida todo el bloque, no solo la línea con el error.
- Autoría no declarada: seguir usando "nuestro equipo" en vez de un schema Person con nombre y URL real.
- Duplicar el mismo tipo de schema desde dos fuentes a la vez: tu plugin SEO generando Article automáticamente y tú añadiendo otro Article por WPCode. La mayoría de validadores lo marcan como conflicto.
- No actualizar la fecha de modificación cuando editas un artículo antiguo: para GEO, una fecha desactualizada es una señal de baja confianza.
- Vender el schema como atajo para que ChatGPT te cite: ni OpenAI ni Perplexity han confirmado que lo usen para decidir citas. Es base técnica, no garantía.
- Montar un FAQPage esperando el desplegable en Google: Google retiró ese resultado enriquecido en 2026. Y lo mismo con HowTo, que dejó de mostrarse en 2023.
Checklist final
- Cada artículo clave tiene schema Article con headline, imagen, autor, fecha de publicación, fecha de modificación y publisher.
- Cada FAQ del artículo está también declarada como FAQPage, palabra por palabra igual que en el texto visible.
- La jerarquía de categorías está declarada con BreadcrumbList.
- El autor tiene su propio schema Person, con el mismo nombre y la misma URL en todos los artículos.
- El publisher (nombre y URL) es idéntico en cada pieza de schema Article de tu sitio.
- Has validado el JSON-LD con una herramienta de prueba de resultados enriquecidos antes de darlo por bueno.
- Si tu plugin SEO no tiene editor de schema por entrada, tienes un fragmento de WPCode por artículo, con su condición de URL bien puesta.
Resumen
El schema no sustituye al contenido ni al SEO técnico de siempre: es la capa que le permite a un modelo de IA confirmar, sin tener que adivinar, qué es tu contenido, quién lo firma y qué entidad hay detrás. Para un blog o una web de servicios, Article, FAQPage, BreadcrumbList y Person cubren la mayoría de los casos, siempre que los datos de autor y publisher sean exactamente los mismos en cada página. Si tu WordPress no tiene un editor de schema nativo, WPCode con lógica condicional por URL es una alternativa gratuita que ya funciona en este mismo blog.
Preguntas frecuentes
¿El schema mejora directamente mi posición en Google o solo ayuda al GEO?
Google no lo documenta como factor de ranking: sirve para que entienda mejor el contenido y para ser elegible en algunos resultados enriquecidos, como las migas de pan. Ojo, el rich result de FAQ ya no se muestra desde 2026. Para GEO, su valor es reducir la ambigüedad sobre qué es tu contenido y quién lo firma, no subir posiciones por sí solo.
¿Necesito saber programar para añadir JSON-LD a mi web?
No hace falta ser desarrollador, pero sí entender la estructura básica de los campos y comprobar que el código es válido. Si tu plugin SEO no lo genera automáticamente, herramientas como WPCode permiten insertarlo sin tocar archivos del tema.
¿Puedo usar solo FAQPage sin Article ni BreadcrumbList?
Puedes, pero pierdes la mayor parte del efecto: es la combinación de qué es el contenido, quién lo firma y dónde está dentro de tu sitio la que da una imagen completa de entidad, no un tipo de schema aislado.
¿Cómo compruebo que mi schema es válido?
Con cualquier herramienta de prueba de resultados enriquecidos o un validador de Schema.org: pegas la URL o el código y te indica si hay errores de sintaxis o campos obligatorios ausentes.
¿Cuántos artículos de mi web necesitan schema para que se note en GEO?
No hace falta hacerlo en todo el sitio de golpe. Tiene más sentido empezar por las piezas de tu cluster de contenido que quieres que una IA cite primero, y declarar ahí una entidad perfectamente consistente, antes de escalarlo al resto.
Fuentes consultadas
Google: funciones de IA y tu web
Google: FAQ, estado del resultado enriquecido
Google: datos estructurados de Article
Search Engine Roundtable: el schema y Copilot
Validador de Schema.org
Si no sabes por dónde empezar o quieres que alguien revise si tu schema actual está bien implementado, es exactamente el tipo de cosas que reviso dentro de una auditoría SEO.
¿Quieres que revise el schema de tu web y te diga qué le falta para que las IA generativas lo entiendan bien? Cuéntame tu caso, sin coste ni compromiso.