¿Sirve el llms.txt? Mi experimento con los logs del servidor
- Experimento
- M de Mención
- En curso
¿Alguien lee mi llms.txt? Lo voy a contar con los logs.
Antes de empezar ya tengo dos hallazgos: a mi llms.txt le faltaban 4 de mis 10 artículos, y 7 de cada 10 webs de clínicas que ChatGPT usa como fuente no tienen llms.txt.
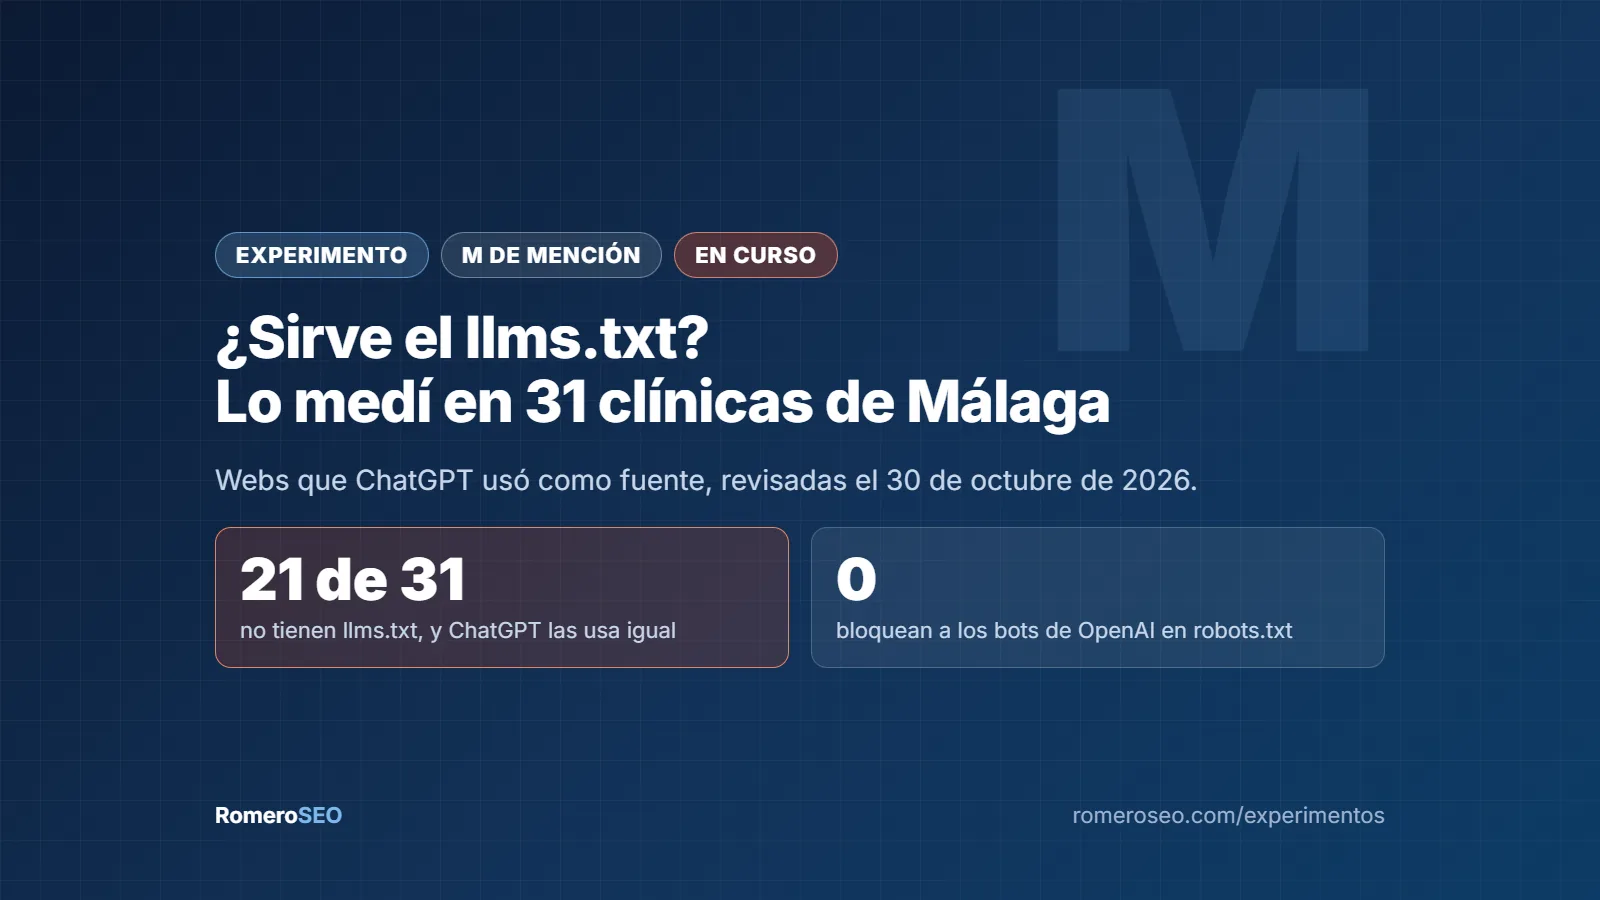
Para aparecer en Google, el llms.txt no sirve: Google dice que lo ignora. Para ChatGPT, no hay pruebas de que ayude a que te citen. De 31 webs de clínicas dentales de Málaga que ChatGPT usó como fuente, 21 no tenían llms.txt el 30 de octubre de 2026. Tenerlo no hace daño, y no tenerlo no te deja fuera.
| Hipótesis | Los bots de IA apenas piden el llms.txt de una web pequeña como la mía |
|---|---|
| Datos propios | 31 webs de clínicas dentales de Málaga, revisadas el 30 de octubre de 2026, y los registros de mi servidor durante 60 días |
| Línea base | 29 de octubre de 2026 |
| Estado | En curso. Esta ficha se actualizará con los resultados de los registros |
| Fase del método | M de Mención: ¿cómo aparece la marca en las nuevas experiencias generativas? |
Qué se sabe del llms.txt en 2026
El llms.txt es un archivo de texto en la raíz de una web que resume su contenido y sus enlaces principales para los modelos de lenguaje. Es una propuesta abierta, no un estándar, y su efecto en la visibilidad no está demostrado.
- Google no lo usa. En su guía para aparecer en las funciones de IA de la búsqueda, Google dice que no hacen falta archivos nuevos para la IA y que puedes mantener un llms.txt para otros servicios, pero que su buscador lo ignora: ni ayuda ni perjudica.
- Los estudios grandes no encuentran efecto. Un análisis de SE Ranking sobre unos 300.000 dominios no encontró relación entre tener el archivo y ser citado por la IA.
- Chrome sí lo mira. Lighthouse incluye una comprobación del llms.txt dentro de sus auditorías para agentes de IA. Si no existe lo marca como no aplicable; solo avisa si tu servidor responde con un error.
Lo que encontré en 31 webs de clínicas de Málaga que ChatGPT usa como fuente
De las 31 webs de clínicas que ChatGPT usó como fuente en mi estudio, solo 10 tenían un llms.txt válido. Las otras 21 no lo tenían, y ChatGPT las usó igual. Si el archivo fuera necesario para que te citen, ese dato no se daría.
Cuatro detalles que no salen en las guías de "qué es el llms.txt":
- Un tercio es mucho, pero no prueba nada. El 32 % está muy por encima del 10 % que midió SE Ranking, aunque son muestras distintas y no se pueden comparar directamente. Puede que las clínicas que más cuidan su web hagan las dos cosas: tener llms.txt y salir en ChatGPT. Eso no significa que una cause la otra.
- Muchos no los escribe nadie. Al menos 3 de los 10 los genera un plugin SEO de WordPress, y lo dicen en la primera línea del archivo. Hay clínicas con llms.txt que probablemente ni saben que lo tienen.
- Un falso llms.txt. Una web responde a /llms.txt con una página web y un código 200, como si el archivo existiera. Para cualquier herramienta que solo mire el código de respuesta, parece que está. Lo he contado como inexistente.
- Nadie cierra la puerta a OpenAI. Ninguna de las 31 bloquea a los bots de OpenAI en su robots.txt. Solo 4 mencionan algún bot de IA, y las 2 que bloquean alguno lo hacen con rastreadores de otras empresas (Common Crawl y ByteDance).
La línea base de mi web, 29 de octubre de 2026
| Archivo | romeroseo.com/llms.txt, responde 200, 4.462 bytes, 30 líneas |
|---|---|
| Tipo | Archivo estático. Última modificación: 16 de octubre de 2026 |
| Enlaces | 20. Todos responden, pero uno apunta a una URL antigua que redirige a /schema-geo/ |
| Artículos que faltan | 4 de los 10 publicados: Core Web Vitals, SEO para clínicas dentales, el estudio de ChatGPT y clínicas de Málaga, y por qué un negocio no aparece en Google Maps |
Cómo voy a medir quién lee mi llms.txt
- Actualizar el llms.txt con todas las entradas publicadas y la URL buena de schema, y anotar la fecha.
- Durante 60 días, sacar de los registros de acceso del servidor las peticiones a /llms.txt, agrupadas por día y por agente de usuario. Sin guardar direcciones IP.
- Comparar con las peticiones a robots.txt y a la portada en el mismo periodo, para tener una referencia de cuánto rastrean esos mismos bots.
- Publicar el resultado aquí, salga lo que salga.
Lo que este experimento no podrá decir
- Si el archivo hace que me citen más. Que un bot lo descargue no significa que lo use al responder.
- Nada sobre webs grandes. Es una web reciente y con poco tráfico.
- Quién se hace pasar por quién. El agente de usuario se puede falsificar. Lo indicaré si veo casos dudosos.
Mientras tanto, revisa el tuyo
- Abre tudominio.com/llms.txt. Si no existe, no pasa nada: para Google no cuenta.
- Si existe, comprueba que es texto y no una página web, que están tus páginas importantes y que ningún enlace va a una URL antigua.
- Mira si lo genera un plugin o es un archivo fijo. Si es fijo, apúntate revisarlo cada vez que publiques.
- Abre tudominio.com/robots.txt y comprueba que no bloqueas sin querer a los bots que te interesan, como OAI-SearchBot, el que usa ChatGPT para sus búsquedas.
Preguntas frecuentes
¿Qué es el llms.txt?
Es un archivo en formato Markdown que se coloca en la raíz de la web y resume qué es el sitio y cuáles son sus páginas principales, pensado para modelos de lenguaje y agentes de IA. Es una propuesta abierta, no un estándar obligatorio.
¿El llms.txt ayuda a salir en ChatGPT?
No hay pruebas de que ayude. Ningún gran proveedor de IA ha confirmado públicamente que lo use para elegir fuentes, los estudios grandes no ven efecto y, en mi muestra, 21 de 31 webs que ChatGPT citaba no lo tenían.
¿Google usa el llms.txt?
No. Google dice en su documentación que su buscador lo ignora y que no afecta a la visibilidad, ni para bien ni para mal, tampoco en sus funciones de IA.
¿Vale la pena crear un llms.txt?
Si tu web lo genera sola con un plugin, déjalo, porque no cuesta nada. Si hay que hacerlo a mano, antes tienen más impacto las reseñas, una página por servicio y que tu web diga con claridad qué haces y dónde.
Cómo hice el análisis de las clínicas
Partí del recuento de fuentes de mi estudio de 75 respuestas de ChatGPT sobre dentistas en Málaga, con datos públicos. Me quedé con las webs propias de clínicas y dejé fuera directorios, portales, una clínica de Madrid, un dominio caducado, una web que no cargaba y un segundo dominio del mismo centro. Quedaron 31. El 30 de octubre de 2026 pedí a cada web su /llms.txt y su /robots.txt y comprobé qué devolvían. Conté como válido solo un archivo de texto con respuesta 200. No publico los datos de cada clínica, solo el resultado agregado.
Antes que el llms.txt, lo que sí cuenta
En mi estudio de clínicas en Málaga, lo que separaba a las que recomienda ChatGPT de las que ignora eran las reseñas y las páginas por tratamiento, no un archivo. Eso es lo que reviso en una auditoría SEO y GEO.
Ver la auditoría SEO y GEOVer todos los experimentosFuentes consultadas: Google Search Central, guía de optimización para funciones de IA y su registro de cambios; Chrome for Developers, auditoría llms.txt de Lighthouse; especificación de llms.txt; estudio de SE Ranking citado por Security Boulevard y AI SaaS Radar. Datos de las clínicas: análisis propio de RomeroSEO, 30 de octubre de 2026.