Audité mi propia web: 3 errores que se veían perfectamente bien
- Hallazgos
- E de Evidencia
- Corregidos
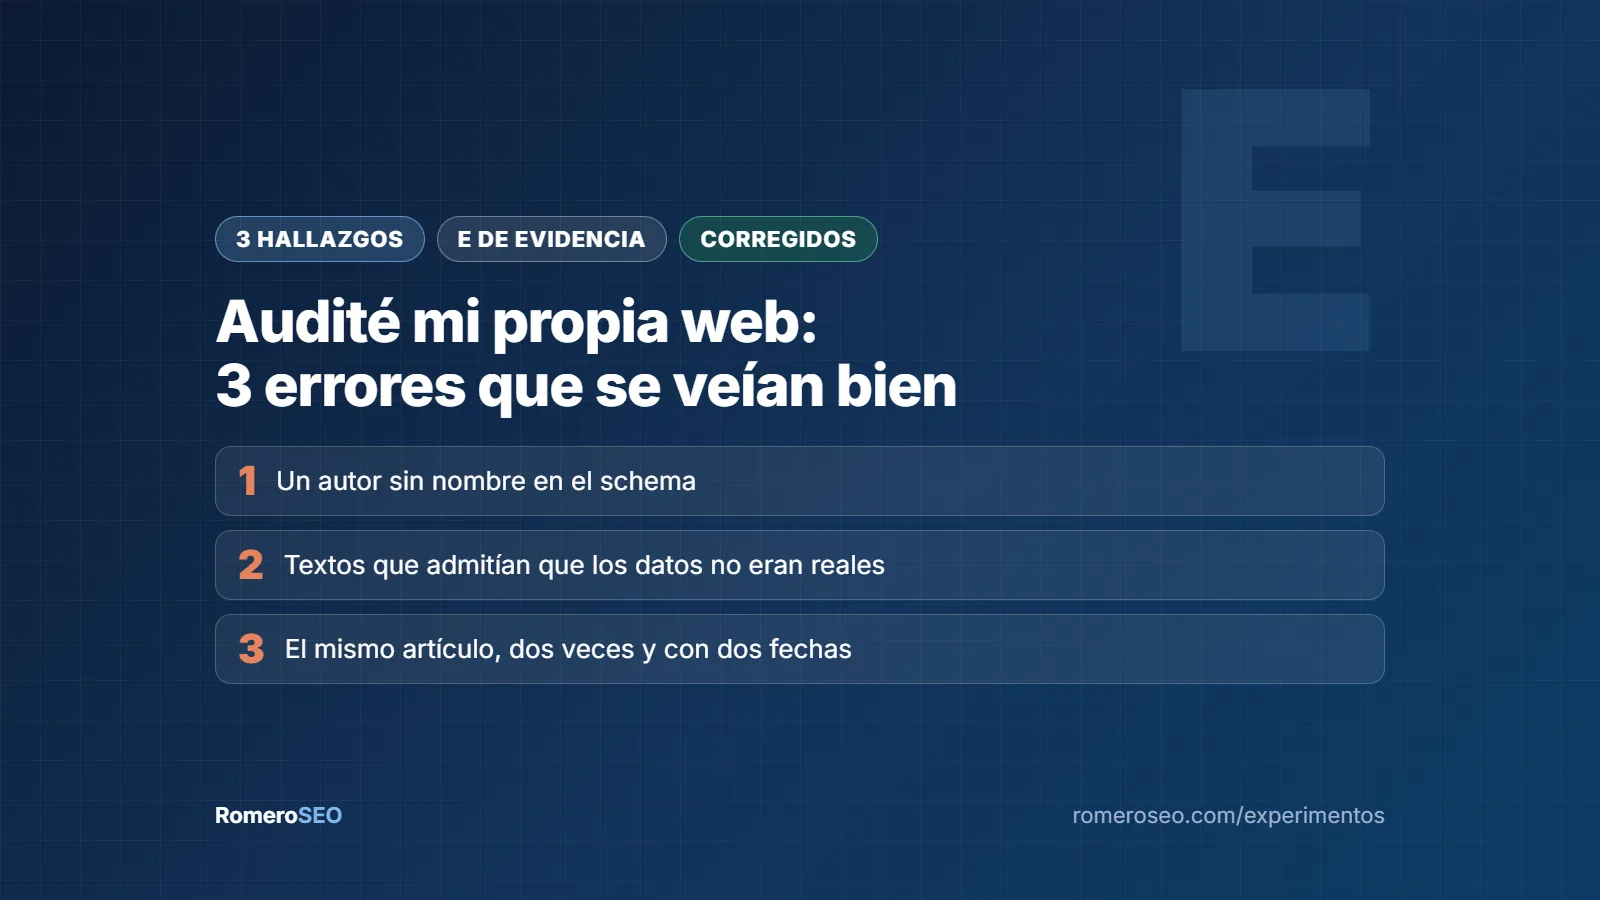
Antes de auditar la web de nadie, audité la mía. Encontré tres errores que se veían perfectamente bien.
Ninguno rompía nada a la vista. Los tres le quitaban credibilidad a la web justo donde más la necesita.
Un error de SEO que se ve es fácil de arreglar: una página caída, una imagen rota, un título cortado. Los que me preocupan son los que no se ven. Un error de confianza es cualquier cosa en tu web que contradice lo que la propia web afirma: un autor sin nombre en el código, un dato que la página reconoce como falso o dos fechas distintas para el mismo artículo. El visitante no siempre lo nota. Google y los sistemas de IA que leen tu código, sí pueden.
Estos tres los encontré en romeroseo.com, mi propia web. Te cuento qué vi, qué cambié y, sobre todo, lo que no puedo afirmar.
| 1. Autor sin nombre en el schema | Todos los artículos y casos. 11 de octubre de 2026 |
|---|---|
| 2. Textos que admitían datos no reales | /consultoria-seo/ y /seo-local/. 20 de septiembre de 2026 |
| 3. El mismo artículo, dos veces en el schema | /schema-geo/. Verificado corregido el 29 de octubre de 2026 |
Los tres pertenecen a la E de mi método ROMERO, la de Evidencia: ¿puede demostrarse lo que la web afirma? Ninguno tiene impacto medido, y más abajo explico por qué.
1. Mi schema sabía quién era el autor, pero no decía su nombre
El marcado Article de mis artículos apuntaba al autor con una referencia interna, pero sin decir su tipo, su nombre ni su página. La firma visible estaba bien: mi nombre y mi foto. El fallo estaba solo en el código que leen Google y los sistemas de IA.
Lo detecté comparando mi JSON-LD con la documentación de Google sobre el marcado Article. Google recomienda que el autor lleve su tipo (Person si es una persona), su nombre en author.name y una URL que lo identifique en author.url, como una página "sobre mí".
"author": {
  "@id": "https://romeroseo.com/#person"
}"author": {
"@type": "Person",
"@id": "https://romeroseo.com/#person",
"name": "Juan Romero",
"url": "https://romeroseo.com/sobre-mi/"
}El cambio se hizo una sola vez, en la plantilla que genera el Article de todos los artículos y casos. En la misma corrección el publisher pasó a llevar también su nombre y su logo dentro del Article. Lo comprobé en vivo el 29 de octubre de 2026 en los artículos de schema para GEO y de AI Overviews.
Y un borrador que iba a salir firmado por la cuenta de administración
Revisando la autoría vi que el borrador del artículo de Core Web Vitals tenía como autor la cuenta de administración de WordPress, que se llama "romeroseo", y no mi usuario. Si se hubiera publicado así, la firma y el schema habrían dicho que lo escribió una marca, no una persona. Lo cambié antes de publicar, y hoy el artículo sale firmado por Juan Romero.
2. Mi propia web admitía que sus datos no eran reales
Dos bloques de mis páginas de servicio enseñaban un ejemplo de trabajo y, justo después, un texto reconocía que esos datos no eran reales. Era texto de relleno y se quedó publicado: en /consultoria-seo/, en el bloque "Así trabajo", y en /seo-local/, en "Así lo reviso".
Quien llega a una página de servicio busca una razón para confiar. Si la propia página le dice que lo que acaba de ver no es real, la duda se extiende al resto: los precios, los casos, las promesas.
Lo encontré leyendo mis páginas como las leería un cliente que no me conoce, de arriba abajo y sin saltarme nada. Técnicamente estaban perfectas. Es el tipo de error que no sale en un informe automático.
Esto es lo que cambié el 20 de septiembre de 2026:
- Eliminé los dos textos de relleno.
- Enlacé la primera tarjeta de /consultoria-seo/ con el caso real de Ayamonte Turismo que hay en esa misma página.
- Dejé a propósito las etiquetas "Ejemplo ilustrativo" de las tarjetas de /seo-local/. Explican un esquema de trabajo, no presentan un resultado, y la etiqueta lo dice antes de que nadie se confunda.
3. El mismo artículo, dos veces en el schema y con dos fechas
Mi guía sobre schema para GEO tenía dos bloques Article para la misma página, con fechas distintas. Justo la página donde no podía pasar. Un validador no lo marca como error: dos bloques bien escritos son válidos aunque se contradigan entre sí.
La causa eran dos piezas haciendo el mismo trabajo. Una plantilla global genera el Article de todos los artículos, y un fragmento añadido solo para ese artículo generaba otro Article con otra fecha.
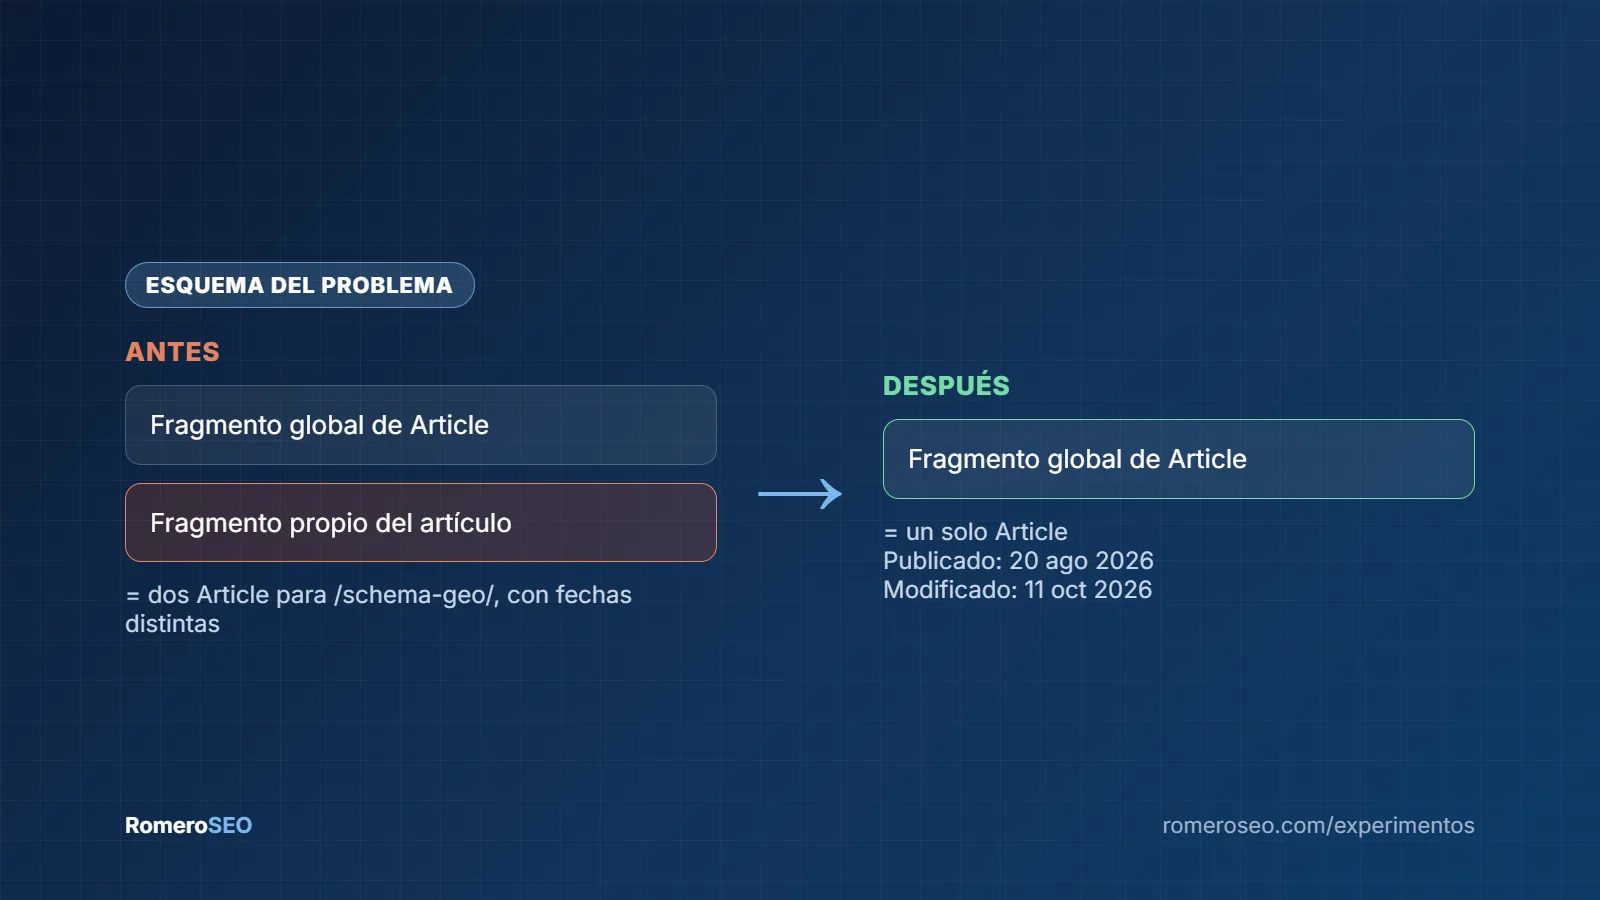
Google pide que la fecha visible y la de los datos estructurados coincidan. Con dos Article y dos fechas, al menos uno contradice lo que ve el lector. Y en GEO la consistencia es la base: si tu propio marcado se contradice, le das a cualquier sistema un motivo para no fiarse de él.
A 29 de octubre de 2026 la página tiene un único Article, publicado el 20 de agosto de 2026 y modificado el 11 de octubre de 2026, con el autor marcado como persona.
Lo que no puedo afirmar
No te voy a enseñar una curva de tráfico y decir que fue por esto. Estas son las razones:
- Ninguno de los tres tiene impacto medido. La web es reciente, tiene poco tráfico y en esas mismas semanas publiqué contenido nuevo. Cualquier subida o bajada sería imposible de atribuir a uno de estos cambios.
- No sé qué fecha escogía Google cuando había dos Article. No lo comprobé antes de corregirlo.
- No tengo ningún dato de que Google penalizara los textos de relleno. El daño que veo es de confianza, para el visitante y para cualquier sistema que lea la página buscando pruebas.
Por eso son hallazgos y no experimentos. Corrigen cosas que pide la documentación oficial o el sentido común, sin más promesas. Con la guía de Google sobre contenido hecho con IA hice lo mismo y lo cuento en este otro experimento.
Cómo saber si a tu web le pasa lo mismo
- Abre un artículo, mira el código fuente y busca
"author"dentro del JSON-LD. Comprueba que tiene@type,nameyurl, y que el nombre coincide con la firma visible. - En WordPress, revisa con qué usuario se crean los borradores. Si es la cuenta de administración, cambia el autor antes de publicar.
- Busca en tu web palabras como "ejemplo", "demo", "ficticio", "lorem" o "placeholder". Un rastreador con búsqueda personalizada lo hace en minutos.
- Coge cada cifra de tus páginas de servicio y pregúntate de dónde sale. Si no tiene fuente, o se marca como esquema o se quita.
- Pasa un artículo por la prueba de resultados enriquecidos o el validador de Schema.org y cuenta los Article o BlogPosting. Tiene que haber uno.
- Si usas un plugin SEO y además fragmentos propios de JSON-LD, revisa que no generen los dos el mismo tipo.
Lo que un informe automático no te va a marcar
En una auditoría leo tu web como un cliente que todavía no se fía de ti y reviso que tu schema diga lo mismo que tu página. Ahí salen cosas que ninguna nota sobre 100 detecta.
Ver la auditoría SEO y GEOVer todos los experimentosFuentes consultadas: Google Search Central, datos estructurados de Article (author.name, author.url y buenas prácticas de autoría) y Google Search Central, fechas de publicación (coherencia entre fecha visible y datos estructurados).